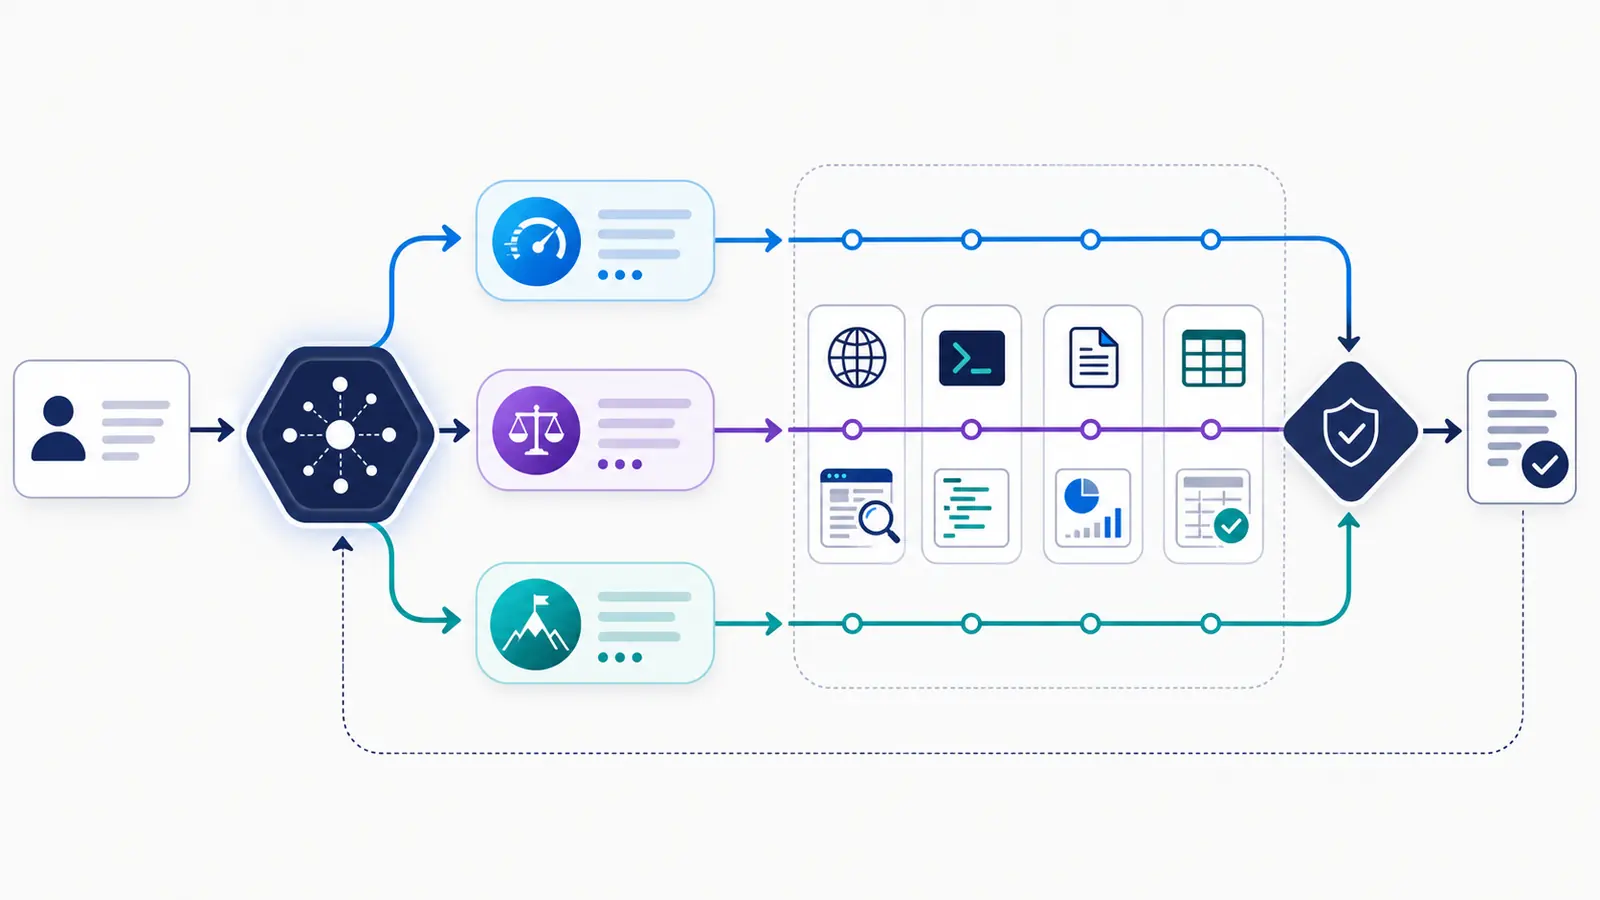
GPT-5.6 como núcleo de un sistema que combina modelos, herramientas y datos.
GPT-5.6 no es simplemente “otro modelo más potente”. El cambio importante está en cómo se diseña una solución alrededor del modelo: qué nivel de capacidad se usa para cada tarea, cuándo conviene activar herramientas, cómo se conserva el contexto y qué procesos merece la pena dividir entre varios agentes. Para una empresa o un profesional, esa arquitectura importa bastante más que ganar unos puntos en una prueba sintética.
OpenAI presentó la familia GPT-5.6 con tres niveles —Luna, Terra y Sol— orientados a distintas relaciones entre coste, velocidad y capacidad. La consecuencia práctica es clara: ya no tiene sentido enviar cada petición al modelo de mayor capacidad por defecto. Un sistema bien planteado reserva el razonamiento más costoso para las decisiones difíciles y deja las tareas repetitivas en manos de opciones más ágiles.
En esta guía veremos qué cambia realmente, cómo elegir modelo y esfuerzo de razonamiento, y qué pruebas conviene hacer antes de migrar un flujo que ya funciona. La referencia principal es la guía oficial para desarrolladores de GPT-5.6, complementada con recomendaciones prácticas para proyectos reales.
Qué cambia de verdad con GPT-5.6
La novedad no se limita a producir mejores respuestas. GPT-5.6 refuerza un patrón que ya se estaba consolidando: una aplicación de IA moderna es un sistema de orquestación. El modelo interpreta la intención, decide si necesita consultar una fuente o ejecutar una herramienta, conserva el estado de la tarea y devuelve un resultado que el software puede validar.
Esto afecta a cuatro áreas:
- Selección dinámica del modelo: el nivel de capacidad se adapta a la dificultad y al riesgo de cada solicitud.
- Uso programático de herramientas: el modelo puede trabajar con funciones, búsquedas, bases de datos o procesos internos sin depender de una conversación manual.
- Arquitecturas con varios agentes: una tarea compleja puede repartirse entre componentes especializados, siempre que exista un coordinador y controles claros.
- Optimización del contexto: el almacenamiento en caché de prompts y la estabilidad de los prefijos reducen trabajo repetido en conversaciones o flujos largos.
Si quieres entender la evolución que conduce a este enfoque, puedes revisar nuestro análisis sobre GPT-5 y el futuro del razonamiento multimodal. GPT-5.6 lleva esa idea un paso más cerca de una implementación operativa.
Luna, Terra o Sol: cómo elegir sin pagar de más
No existe un modelo correcto para todos los casos. La elección depende de la complejidad, el volumen, la latencia aceptable y el coste de un error. Como regla general, empieza por el nivel más ligero que supere tus pruebas y escala solo cuando los datos lo justifiquen.
| Tipo de trabajo | Nivel inicial sugerido | Qué debes medir | Cuándo escalar |
|---|---|---|---|
| Clasificación, extracción y reformateo | Luna | Exactitud del esquema, latencia y coste | Si aparecen ambigüedades o documentos difíciles |
| Redacción, análisis y automatizaciones habituales | Terra | Calidad, consistencia y llamadas correctas a herramientas | Si la tarea exige planificación profunda o decisiones delicadas |
| Investigación compleja, código crítico o estrategia | Sol | Tasa de éxito completa y calidad de las decisiones | No se escala: se mejora el contexto, las pruebas o la arquitectura |
Esta tabla es un punto de partida, no una verdad universal. Una extracción aparentemente sencilla puede requerir el modelo más capaz si el documento contiene excepciones legales. Del mismo modo, un resumen largo pero muy estructurado puede resolverse con un modelo más ligero.
La guía oficial señala que los niveles pequeños pueden igualar capacidades anteriores en determinados escenarios con menor coste. La palabra decisiva es “determinados”: hay que medir con ejemplos propios. Un conjunto de evaluación formado por 30 o 50 casos reales suele revelar más que una demostración espectacular elegida a mano.
El esfuerzo de razonamiento también es una variable
Elegir el modelo es solo una parte. En tareas que admiten distintos niveles de razonamiento, el esfuerzo configurado modifica la latencia, el consumo y, en ocasiones, la fiabilidad. Subirlo al máximo para todo suele ser una mala decisión económica.
Una política útil puede ser esta:
- Usa esfuerzo bajo para transformaciones deterministas, clasificación o borradores rápidos.
- Sube a un nivel medio cuando haya varias instrucciones, fuentes o herramientas.
- Reserva el esfuerzo alto para planificación, depuración difícil y decisiones cuyo fallo sea costoso.
- Si incluso el nivel alto falla, revisa el contexto y la definición de éxito antes de seguir aumentando capacidad.
Un prompt confuso no se arregla automáticamente con más razonamiento. Es mejor separar objetivos, datos, restricciones y formato de salida. En nuestra guía de mega-prompts e ingeniería avanzada explicamos cómo ordenar ese contexto sin convertir el prompt en un bloque imposible de mantener.
Responses API y herramientas: el salto de chat a sistema
Para proyectos nuevos, la pieza central no debería ser una cadena de mensajes pegada a una interfaz. La documentación oficial de Responses API plantea una interfaz preparada para combinar generación, estado y herramientas. Esto facilita construir asistentes que buscan información, consultan datos internos o ejecutan acciones autorizadas.
El patrón básico es sencillo:
- La aplicación envía la petición, el contexto imprescindible y la lista de herramientas disponibles.
- El modelo responde directamente o solicita una herramienta con argumentos estructurados.
- Tu servidor valida permisos y parámetros antes de ejecutar nada.
- El resultado vuelve al modelo para que complete la respuesta.
- La aplicación registra el recorrido para poder auditarlo y mejorarlo.
La validación del servidor es imprescindible. Que el modelo pida “enviar un correo” o “actualizar un pedido” no significa que la acción deba ejecutarse sin comprobar identidad, permisos, límites y destino. La IA propone; el sistema autorizado decide.
Programmatic tool calling: menos conversación, más control
GPT-5.6 refuerza las llamadas programáticas a herramientas. En lugar de improvisar una secuencia textual, el modelo puede elegir funciones definidas por el desarrollador y proporcionar parámetros que la aplicación valida. Es especialmente útil en automatización, soporte, análisis de datos y operaciones internas.
Por ejemplo, un agente de soporte podría:
- identificar el pedido a partir de un dato verificado;
- consultar su estado en el sistema logístico;
- revisar la política aplicable;
- proponer una respuesta;
- pedir aprobación humana si existe una devolución o compensación.
Ese último paso marca la diferencia entre una demostración y un proceso empresarial seguro. Las acciones irreversibles, económicas o sensibles deben incorporar aprobación, límites e historial.
¿Cuándo tiene sentido una arquitectura multiagente?
Varios agentes no garantizan un mejor resultado. Añaden coordinación, más llamadas, más latencia y nuevas formas de fallo. Funcionan cuando una tarea se puede dividir en especialidades con entregables verificables: por ejemplo, un agente investiga, otro analiza datos y un tercero revisa coherencia y fuentes.
Una arquitectura razonable tiene un orquestador que reparte el trabajo, define qué puede hacer cada agente y reúne los resultados. Sin ese control, dos agentes pueden duplicar tareas, contradecirse o entrar en ciclos innecesarios.
Antes de adoptar este patrón, prueba una solución de un solo agente con buenas herramientas. Si la tasa de éxito se estanca por falta de especialización o contexto, entonces la separación puede estar justificada. Nuestro artículo sobre agentes autónomos frente al software tradicional profundiza en esta frontera.
Prompt caching: ahorrar sin degradar la respuesta
En aplicaciones con instrucciones extensas o contexto repetido, volver a procesar el mismo prefijo en cada petición supone coste y latencia innecesarios. La guía de GPT-5.6 destaca el uso de caché de prompts y recomienda mantener puntos de ruptura deterministas. También indica una retención mínima de 30 minutos para los prefijos almacenados, aunque la configuración concreta debe comprobarse en la documentación vigente de la API.
Para aprovecharlo, coloca al principio la información estable: instrucciones del sistema, políticas, definiciones de herramientas y contexto que se reutiliza. Deja para el final los datos variables del usuario o de la operación. Si cambias el prefijo constantemente —por ejemplo, insertando una fecha dinámica al comienzo— reducirás las coincidencias de caché.
No uses la caché como sustituto de una estrategia de contexto. Los documentos irrelevantes siguen siendo irrelevantes aunque cueste menos procesarlos. La prioridad es seleccionar la información correcta y después optimizar su reutilización.
Cinco pruebas antes de migrar un proyecto
1. Evaluación con casos reales
Reúne ejemplos normales, difíciles y fallidos de tu sistema actual. Define una puntuación objetiva: extracción correcta, solución aceptada, código que pasa pruebas o respuesta aprobada por un especialista. Compara niveles de modelo y razonamiento con la misma muestra.
2. Salidas estructuradas
Comprueba que la respuesta respeta el esquema esperado, incluidos campos opcionales, valores nulos y excepciones. Una respuesta brillante que rompe el parser es un fallo de producción.
3. Herramientas y permisos
Simula parámetros erróneos, intentos de acceder a datos no autorizados y herramientas temporalmente caídas. El sistema debe fallar de forma segura y explicar qué necesita para continuar.
4. Latencia y coste de extremo a extremo
No midas únicamente la llamada al modelo. Incluye búsquedas, funciones externas, reintentos y validaciones. En algunos flujos, la herramienta remota tarda más que el razonamiento.
5. Observabilidad
Registra la versión del modelo, la configuración, las herramientas llamadas y el resultado de cada control, evitando almacenar datos personales innecesarios. Sin trazabilidad es muy difícil distinguir un problema del prompt, del modelo o de una integración.
Checklist de migración a GPT-5.6
- Define una línea base de calidad, coste y latencia antes de cambiar nada.
- Prueba primero el nivel más económico compatible con el riesgo.
- Separa instrucciones estables de datos variables para favorecer la caché.
- Valida todas las llamadas a herramientas en el servidor.
- Incluye aprobación humana para acciones sensibles o irreversibles.
- Ejecuta pruebas automáticas sobre formatos, permisos y casos límite.
- Despliega de forma gradual y conserva una ruta de reversión.
- Revisa periódicamente ejemplos fallidos y actualiza el conjunto de evaluación.
Errores frecuentes al adoptar una nueva familia de modelos
El primero es migrar únicamente cambiando el nombre del modelo. Puede funcionar, pero desaprovecha nuevas capacidades y oculta incompatibilidades. El segundo es seleccionar siempre el nivel superior “por seguridad”, sin comprobar si la mejora compensa el coste. El tercero es introducir varios agentes antes de contar con métricas y controles.
También conviene evitar prompts que obligan al modelo a exponer cadenas internas de razonamiento. Para mejorar la fiabilidad, pide una conclusión, evidencias verificables, supuestos y una comprobación final. Si te interesa el tema, consulta nuestra explicación sobre chain of thought y razonamiento en prompts.
Preguntas frecuentes sobre GPT-5.6
¿GPT-5.6 sustituye automáticamente a todos los modelos anteriores?
No. Una migración debe basarse en evaluaciones propias, presupuesto, latencia y requisitos de estabilidad. Un modelo anterior puede seguir siendo suficiente para un flujo consolidado.
¿Qué modelo de la familia debería probar primero?
Empieza por el nivel más ligero que parezca compatible con la tarea y compáralo con Terra o Sol mediante el mismo conjunto de pruebas. Escala cuando exista una mejora medible, no por intuición.
¿Necesito varios agentes para aprovechar GPT-5.6?
No. Muchas aplicaciones funcionan mejor con un solo agente, buenas herramientas y controles claros. Los sistemas multiagente son útiles cuando hay especialidades separables y un orquestador puede verificar cada resultado.
¿La caché de prompts cambia las respuestas?
Su objetivo es reutilizar el procesamiento de un prefijo idéntico, reduciendo trabajo repetido. Aun así, debes medir el comportamiento completo de la aplicación y mantener estable el contexto que quieres reutilizar.
¿Es seguro permitir que el modelo ejecute acciones?
Solo si la aplicación valida identidad, permisos, argumentos y límites fuera del modelo. Las operaciones económicas, destructivas o sensibles deberían requerir controles adicionales y, cuando proceda, aprobación humana.
Conclusión: el modelo es una pieza, no toda la solución
GPT-5.6 ofrece una familia más flexible para combinar velocidad, coste y razonamiento. Sin embargo, la ventaja real aparecerá en proyectos que seleccionen bien el nivel, diseñen herramientas seguras, reutilicen contexto estable y midan resultados con casos propios.
La mejor primera acción no es rehacer toda la aplicación. Elige un flujo acotado, reúne ejemplos reales y compara dos configuraciones. Si la mejora es consistente, amplía el despliegue. Esa disciplina convierte una novedad de IA en una mejora de producto verificable.
Acerca del autor